대학원생이나 연구원이라면 11월 23일을 달력에 적어 두세요. 오픈AI가 연구자용 챗GPT 무료 프로그램을 크게 넓혀, 이날(미국 시각) 신청을 받습니다. 추첨이 아니라 선착순이라 날짜가 중요해졌어요.
챗GPT 연구자 무료 신청 11월 23일 시작|Plus 무료, 선착순 5만 건·공동연구자 2명까지
목차 (7)
11월 17일 오픈AI 발표문을 기준으로 바뀐 점과 신청 전 준비를 정리했습니다.
무엇이 바뀌었나
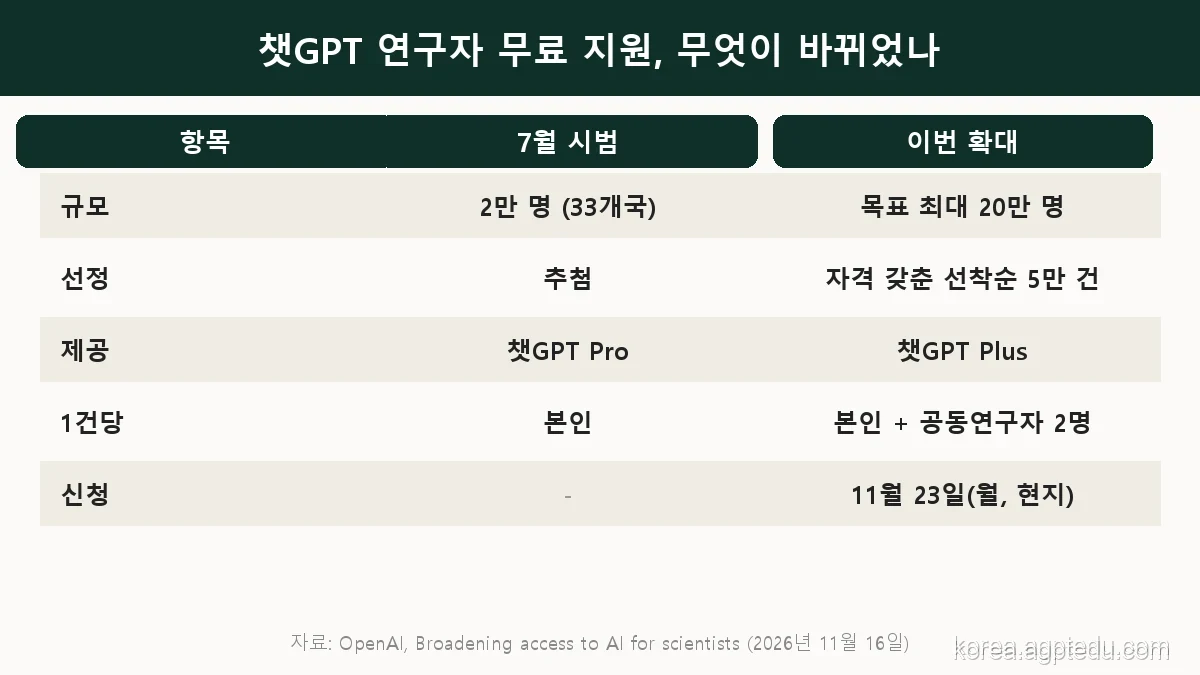
| 항목 | 7월 시범 운영 | 이번 확대 |
|---|---|---|
| 규모 | 2만 명 참여 (33개국) | 전체 목표 최대 20만 명 |
| 선정 방식 | 추첨 | 자격 갖춘 신청 선착순 5만 건 |
| 제공 요금제 | 챗GPT Pro | 챗GPT Plus |
| 1건당 인원 | 본인 | 본인 + 공동연구자 최대 2명 |
| 신청 시작 | - | 11월 23일(월, 현지) |
Pro에서 Plus로 바뀐 이유도 밝혔습니다. 시범 운영 사용량을 보니 대부분이 Plus 한도 안에서 썼다는 거예요. 그만큼 더 많은 팀에 나눠 주겠다는 판단입니다. 5만 건에 3명씩이면 이번 회차에서만 최대 15만 명이 받습니다.
신청 전에 준비할 것
- 자격 요건 확인: 발표문에는 '자격을 갖춘 연구자'라고만 적혀 있습니다. 나라별 조건은 신청 페이지에서 확인해야 해요.
- 공동연구자 2명 정하기: 1건으로 3명이 받으니, 같은 연구실 동료와 미리 정해 두면 좋습니다.
- 대기자 명단 확인: 이미 명단에 올렸다면 신청 시작 전에 메일이 온다고 합니다. 스팸함도 확인하세요.
- 한국 시간 계산: 23일 미국 시각이면 한국은 23일 밤~24일입니다. 선착순이니 공지 시각을 미리 확인해 두세요.
데이터와 학습
오픈AI는 이 프로그램으로 공유한 데이터를 기본적으로 모델 학습에 쓰지 않는다고 밝혔습니다. 미발표 데이터를 다루는 연구자에게는 중요한 대목이죠. 다만 소속 기관의 데이터 반출 규정은 따로 확인해야 합니다.
📌 함께 보면 좋은 가이드: 챗GPT 무료 vs Plus 차이
다른 경로도 있다
- ChatGPT Edu: 대학이 학교 구성원 전체에 챗GPT를 제공하는 기관용 요금제입니다. 학교가 계약했는지 먼저 확인해 보세요.
- GPT-Rosalind 학술 플랜: 생물학 연구용 특화 모델로, 미국 대학 연구실에 최대 30석을 12개월 무료로 줍니다. 국내 연구실은 대상이 아닙니다.
운영자 코멘트
시범 운영 참가자들은 AI 없이 같은 품질로 하려면 시간이 거의 두 배 걸렸을 것이라고 답했다고 합니다. 선착순으로 바뀐 만큼, 관심 있는 연구실이라면 이번 주 안에 공동연구자와 자격 요건을 정리해 두는 게 가장 확실한 준비입니다.
맺음말
- 11월 23일(현지) 신청 시작, 자격을 갖춘 선착순 5만 건에 챗GPT Plus 무료입니다.
- 1건당 본인과 공동연구자 2명, 데이터는 기본적으로 학습에 쓰이지 않습니다.
- 국내 연구자 자격은 신청 페이지의 요건으로 확인하세요.
👉 다음에 읽을 글
- 챗GPT Pro·Business에 API 크레딧 무료 지급 — 연구용으로 API까지 쓴다면 참고하세요.
- 챗GPT 계정 전환 방법 — 연구용·개인용 계정을 나눠 쓸 때 편합니다.
공식 자료
자주 묻는 질문
- 언제부터 신청하나요?
- 오픈AI는 다음 신청을 11월 23일(월, 현지 시각)에 연다고 밝혔습니다. 자격을 갖춘 신청자 가운데 먼저 낸 5만 건에 지원합니다. 이미 대기자 명단에 있고 자격이 되면 신청 시작 전에 활성화 방법을 메일로 보내 준다고 했습니다.
- 무엇을 무료로 주나요?
- 챗GPT Plus입니다. 7월 시범 운영 때는 Pro를 줬지만, 참가자 대부분이 Plus 사용 한도 안에서 썼다는 분석에 따라 더 많은 팀에 주려고 Plus로 바꿨습니다. 1건당 신청자 본인과 공동연구자 최대 2명이 함께 받습니다.
- 한국 연구자도 받을 수 있나요?
- 오픈AI는 전 세계 연구자를 대상으로 한다고 밝혔고, 시범 운영 참가자는 33개국에 걸쳐 있습니다. 나라별 자격 조건은 발표문에 따로 적혀 있지 않아, 신청 페이지의 자격 요건을 확인해야 합니다.
- 연구 데이터가 학습에 쓰이나요?
- 오픈AI는 이 프로그램으로 공유한 데이터를 기본적으로 모델 학습에 쓰지 않는다고 밝혔습니다.